صاحب یک کسب وکار می خواهد یک ایجنت هوش مصنوعی برای پشتیبانی مشتری راه بیندازد. در اولین جلسه با تیم فنی، جمله هایی می شنود که مثل یک زبان دیگر است: «این مدل پنجره زمینه یک میلیون توکنی دارد»، «توکن خروجی پنج برابر توکن ورودی هزینه دارد»، «با حافظه نهان هزینه ورودی به ده درصد می رسد». سر تکان می دهد و فقط یک سوال در ذهنش می ماند: «خب، ماهی چقدر باید خرج کنم و کدام مدل را انتخاب کنم؟»
ما این مقاله را برای همین نوشتیم. قدم به قدم می بینیم مدل زبانی بزرگ چیست، توکن یعنی چه، توکن ورودی و خروجی و حافظه نهان چه فرقی دارند، پنجره زمینه چطور کار می کند، هزینه را چطور حساب کنیم و پارامترهایی که رفتار مدل را کنترل می کنند کدام اند. در پایان هم چند مدل معروف را کنار هم می گذاریم و می بینیم برای کسب وکار شما چه چیزی مهم تر است. اگر این مقاله را تا آخر بخوانید، دفعه بعد در آن جلسه فنی، نه تنها گیج نمی شوید، بلکه می توانید سوال درست بپرسید.
مدل زبانی بزرگ و توکن در یک نگاه
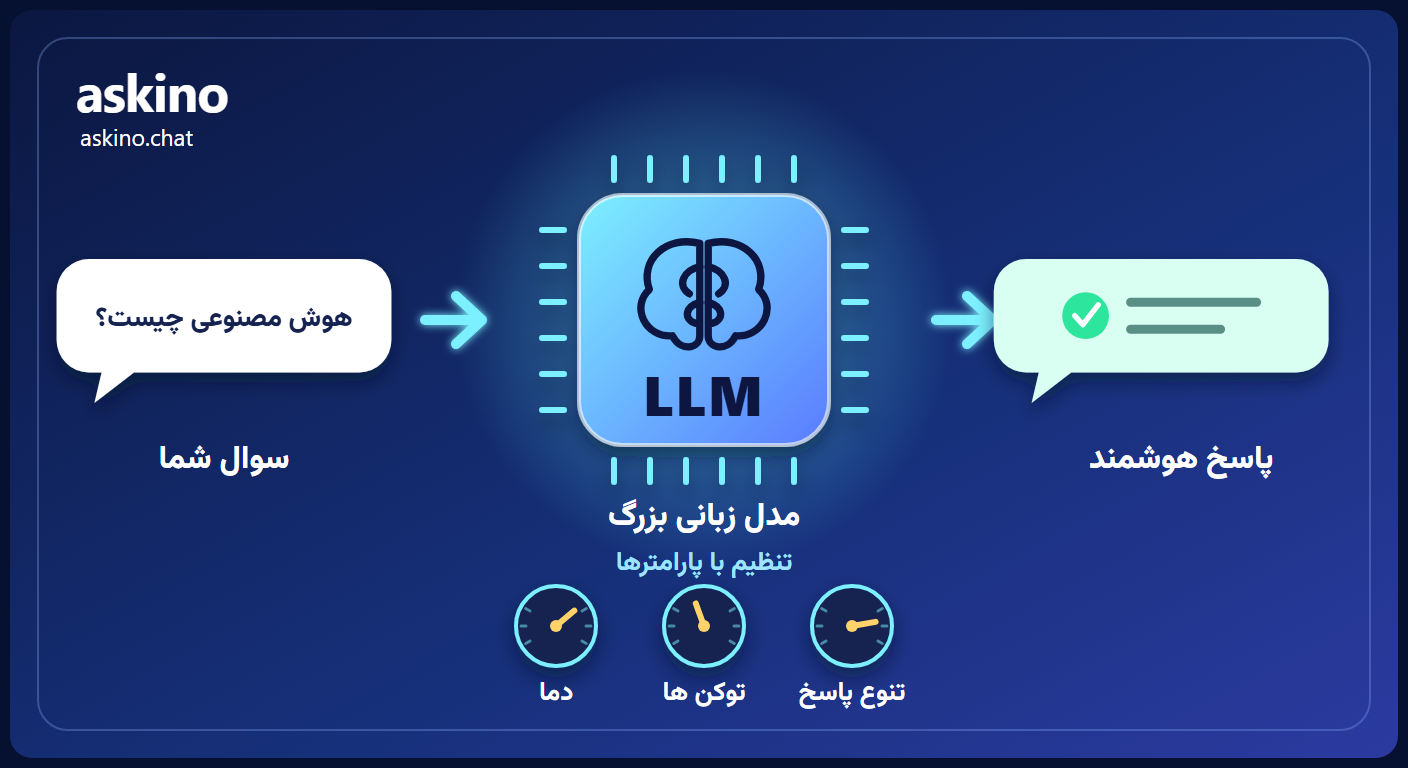
مدل زبانی بزرگ (Large Language Model یا LLM) چیست؟
نرم افزاری که با خواندن حجم عظیمی از متن آموزش دیده تا زبان انسان را بفهمد و متن تولید کند. کار اصلی اش این است که قدم به قدم، محتمل ترین قطعه بعدی متن را پیش بینی کند و از زنجیره همین پیش بینی ها، پاسخ بسازد.
توکن (Token) چیست؟
کوچک ترین قطعه ای از متن که مدل با آن کار می کند؛ ممکن است یک کلمه، بخشی از یک کلمه یا یک علامت باشد. هم محدودیت مدل و هم هزینه استفاده از آن را با توکن می سنجند.
هزینه استفاده از مدل را چطور حساب کنیم؟
معمولاً به ازای هر یک میلیون توکن. توکن های ورودی (چیزی که به مدل می دهید) و توکن های خروجی (چیزی که مدل می نویسد) قیمت جداگانه دارند و توکن های خروجی معمولاً گران ترند.
مدل زبانی بزرگ دقیقاً چیست؟
یک مدل زبانی بزرگ، یک برنامه ریاضی عظیم است که روی میلیاردها جمله آموزش دیده. «بزرگ» در نامش به دو چیز اشاره دارد: حجم داده های آموزشی و تعداد پارامترهای داخلی اش که معمولاً به میلیاردها عدد می رسد.
مهم است که تصویر درستی از آن داشته باشید. مدل زبانی پایگاه داده نیست و پاسخ ها را از پیش ذخیره نمی کند. همچنین یک موتور جست وجو هم نیست. مدل الگوهای زبان و دانش دوران آموزشش را می شناسد. به همین دلیل درباره اطلاعات اختصاصی کسب وکار شما (قیمت امروز، قوانین مرجوعی فروشگاه شما) چیزی نمی داند، مگر این که آن اطلاعات را به او بدهید.
مدل زبانی چطور کار می کند؟
برای فهم هزینه و پارامترها، لازم نیست ریاضیات را بدانید؛ فقط سه مرحله را به خاطر بسپارید.
۱. مدل متن را به توکن تبدیل می کند. جمله «سفارشم کی می رسه؟» را به چند قطعه کوچک می شکند و به هر قطعه یک شماره می دهد.
۲. مدل محتمل ترین قطعه بعدی را پیش بینی می کند. بر اساس همه قطعات قبلی، برای هر توکن ممکن بعدی یک احتمال حساب می کند.
۳. مدل یک توکن انتخاب می کند و همین کار را تکرار می کند. توکن انتخابی را به متن اضافه می کند و دوباره همین فرایند را اجرا می کند تا پاسخ کامل شود. پارامترهایی مثل «دما» دقیقاً در همین مرحله نقش دارند که بعداً می گوییم.
مدل زبانی چطور یاد می گیرد؟
آموزش مدل چند مرحله دارد. اول، مرحله «پیش آموزش» است: مدل روی حجم عظیمی از متن، یاد می گیرد زبان چطور کار می کند. بعد، «تنظیم دقیق» (Fine-tuning) و آموزش با بازخورد انسانی می آید تا مدل یاد بگیرد مفید، شفاف و ایمن پاسخ بدهد. این مراحل را شرکت سازنده انجام می دهد. شما معمولاً مدل را از صفر نمی سازید؛ مدلی آماده برمی گزینید و با دانش و قوانین خودتان تنظیمش می کنید.
توکن (Token) چیست؟
توکن واحد شمارش در دنیای مدل های زبانی است. همان طور که برق را با کیلووات ساعت می سنجند، مدل های زبانی را با توکن می سنجند.
برای انگلیسی، تقریباً هر توکن چهار کاراکتر یا حدود سه چهارم یک کلمه است [منبع: Anthropic، Pricing FAQ]. اما عدد دقیق به زبان و نوع محتوا بستگی دارد. سازنده ها بیشتر مدل ها را روی متن انگلیسی آموزش می دهند؛ به همین دلیل در زبان فارسی معمولاً هر کلمه توکن بیشتری مصرف می کند. یعنی یک پیام فارسی با همان تعداد کلمه، معمولاً از یک پیام انگلیسی هزینه بیشتری دارد. این فقط یک قاعده کلی است؛ برای عدد دقیق باید با ابزار شمارش توکن همان مدل، متن خودتان را بسنجید.
نکته دیگر این است که هر مدل، توکن سازِ (Tokenizer) مخصوص خودش را دارد. به طور مثال Anthropic اعلام کرده مدل های جدیدش (از نسل ۴.۷ به بعد) از توکن ساز تازه ای استفاده می کنند که برای همان متن، حدود ۳۰ درصد توکن بیشتر تولید می کند [منبع: Anthropic، Pricing]. یعنی «تعداد توکن» بین مدل های مختلف مستقیماً قابل مقایسه نیست.
توکن ورودی، توکن خروجی و توکن حافظه نهان
وقتی با یک مدل کار می کنید، سه نوع توکن در صورت حساب می بینید.
توکن ورودی (Input Token)
هر چیزی که به مدل می فرستید: پیام مشتری، دستورالعمل های سیستمی (مثلاً «تو دستیار فروشگاه هستی و با لحن صمیمی جواب می دهی»)، اطلاعات پایگاه دانش، و تاریخچه گفتگو. نکته مهمی که خیلی ها نمی دانند: مدل حافظه خودکار ندارد. در هر پیام جدید، معمولاً برنامه کل سابقه گفتگو را دوباره برای مدل می فرستد. پس هرچه گفتگو طولانی تر شود، توکن ورودی هر پیام بیشتر می شود.
توکن خروجی (Output Token)
هر چیزی که مدل می نویسد. توکن خروجی معمولاً چند برابر گران تر از ورودی است. برای نمونه، طبق قیمت گذاری رسمی Anthropic، مدل Claude Sonnet 5.5 هر میلیون توکن ورودی را دو دلار و هر میلیون توکن خروجی را ده دلار حساب می کند؛ یعنی خروجی پنج برابر گران تر است [منبع: Anthropic، Pricing]. به همین دلیل، پاسخ های کوتاه و دقیق، هم برای مشتری بهترند و هم برای هزینه.
توکن حافظه نهان (Cached Token)
بخش زیادی از ورودی هر پیام، تکراری است: دستورالعمل ها و دانش کسب وکار در همه پیام ها یکسان اند. «حافظه نهان پرامپت» (Prompt Caching) به مدل اجازه می دهد این بخش تکراری را یک بار پردازش کند و دفعه های بعد، با قیمت بسیار کمتر از حافظه بخواند.
طبق مستندات رسمی، Anthropic برای هر بار استفاده از حافظه نهان معمولاً ۱۰ درصد قیمت پایه ورودی حساب می کند. برای ثبت داده در حافظه نهان پنج دقیقه ای ۱.۲۵ برابر و در حافظه نهان یک ساعته ۲ برابر قیمت پایه می گیرد. در حالت پنج دقیقه ای، حافظه نهان از دومین استفاده هزینه اش را برمی گرداند [منبع: Anthropic، Pricing]. سازنده های دیگر هم قیمت مشابهی دارند؛ مثلاً OpenAI برای ورودی حافظه دار مدل های اصلی اش بین پنج تا ده درصد ورودی عادی دریافت می کند [منبع: OpenAI، API Pricing].
برای ایجنت پشتیبانی، حافظه نهان یکی از مؤثرترین راه های کاهش هزینه است، چون دانش کسب وکار در هر پیام تکرار می شود.
پنجره زمینه (Context Window) چیست؟
پنجره زمینه، «حداکثر حجم متنی است که مدل می تواند در یک لحظه ببیند.» هر چیزی که در یک درخواست باید به مدل برسد (دستورالعمل، دانش، تاریخچه گفتگو، پیام جدید) و حتی خروجی که قرار است بنویسد، باید در همین پنجره جا بگیرد.
مثلاً مدل های اصلی Claude (Fable 5.1، Opus 5.5 و Sonnet 5.5) پنجره ای به اندازه یک میلیون توکن دارند. طبق مستندات رسمی، این معادل حدود ۵۵۵ هزار کلمه انگلیسی است؛ و مدل Haiku 4.5 پنجره ۲۰۰ هزار توکنی دارد که حدود ۱۵۰ هزار کلمه می شود [منبع: Anthropic، Models Overview]. برای مقایسه، یک کتاب ۳۰۰ صفحه ای حدود ۱۰۰ هزار کلمه است.
آیا پنجره بزرگ تر همیشه بهتر است؟
نه. چند دلیل دارد:
هزینه. هرچه بیشتر در پنجره بگذارید، توکن ورودی بیشتر می شود و هزینه بالا می رود.
سرعت. ورودی طولانی تر، پردازش طولانی تر یعنی پاسخ دیرتر.
دقت. پژوهشی مشهور با عنوان «گم شدن در میانه» (Lost in the Middle) نشان داد مدل ها در استفاده از اطلاعاتی که وسط یک متن طولانی قرار دارد، معمولاً ضعیف تر از اطلاعات ابتدا و انتها عمل می کنند [منبع: Liu و همکاران، ۲۰۲۳، Lost in the Middle، منتشرشده در Transactions of the Association for Computational Linguistics، ۲۰۲۴]. یعنی پنجره بزرگ نمی تواند جای یک پایگاه دانش مرتب را بگیرد.
راه حل رایج، بازیابی اطلاعات (RAG) است. در این روش همه دانش را نمی فرستید؛ فقط بخش های مرتبط با پیام مشتری را پیدا می کنید و به مدل می دهید.
حداکثر خروجی (Max Output Tokens)
علاوه بر پنجره زمینه، هر مدل یک سقف برای طول یک پاسخ هم دارد. برای نمونه، مدل های اصلی Claude تا ۱۲۸ هزار توکن خروجی و Haiku 4.5 تا ۶۴ هزار توکن [منبع: Anthropic، Models Overview]. برای پشتیبانی مشتری، معمولاً پاسخ های کوتاه تر کافی است و بهتر است سقف خروجی را عمداً پایین بگذارید تا هزینه و طول پاسخ را مهار کنید.
هزینه مدل زبانی بزرگ را قدم به قدم حساب کنیم
فرمول ساده است:
هزینه هر درخواست = (توکن ورودی × قیمت ورودی + توکن خروجی × قیمت خروجی) ÷ ۱٬۰۰۰٬۰۰۰
که سازنده ها قیمت ها را «به ازای هر میلیون توکن» اعلام می کنند. یک مثال فرضی را با قیمت های رسمی Anthropic در زمان نگارش (اکتبر ۲۰۲۶) حساب می کنیم.
فرض های مثال
فرض ها: یک ایجنت پشتیبانی. در هر پیام، ۲۰۰۰ توکن دستورالعمل و دانش ثابت، ۱۵۰۰ توکن تاریخچه گفتگو و ۳۰۰ توکن پاسخ دارد (جمعاً ۳۵۰۰ ورودی و ۳۰۰ خروجی). حجم: ۱۰ هزار پیام در ماه.
هزینه با دو مدل مختلف
با مدل Claude Sonnet 5.5 (دو دلار ورودی و ده دلار خروجی به ازای هر میلیون):
- ورودی: ۳۵۰۰ × ۲ ÷ ۱٬۰۰۰٬۰۰۰ = ۰.۰۰۷ دلار
- خروجی: ۳۰۰ × ۱۰ ÷ ۱٬۰۰۰٬۰۰۰ = ۰.۰۰۳ دلار
- جمع هر پیام: ۰.۰۱ دلار، یعنی حدود ۱۰۰ دلار برای ۱۰ هزار پیام
با مدل Claude Haiku 4.5 (یک دلار ورودی و پنج دلار خروجی به ازای هر میلیون):
- ورودی: ۳۵۰۰ × ۱ ÷ ۱٬۰۰۰٬۰۰۰ = ۰.۰۰۳۵ دلار
- خروجی: ۳۰۰ × ۵ ÷ ۱٬۰۰۰٬۰۰۰ = ۰.۰۰۱۵ دلار
- جمع هر پیام: ۰.۰۰۵ دلار، یعنی حدود ۵۰ دلار برای ۱۰ هزار پیام
اثر حافظه نهان روی هزینه
با حافظه نهان روی Sonnet 5.5 (فرض می کنیم مدل ۲۰۰۰ توکن ثابت را با قیمت یک دهم، یعنی ۰.۲ دلار در میلیون، از حافظه می خواند):
- ورودی ثابت: ۲۰۰۰ × ۰.۲ ÷ ۱٬۰۰۰٬۰۰۰ = ۰.۰۰۰۴ دلار
- ورودی تاریخچه: ۱۵۰۰ × ۲ ÷ ۱٬۰۰۰٬۰۰۰ = ۰.۰۰۳ دلار
- خروجی: ۰.۰۰۳ دلار
- جمع هر پیام: ۰.۰۰۶۴ دلار، یعنی حدود ۶۴ دلار برای ۱۰ هزار پیام
این اعداد یک مثال آموزشی اند: هزینه واقعی به طول گفتگو، دانش ثابت، مدل و درصد برخورد به حافظه نهان بستگی دارد. نکته مهم این است که با دو تصمیم ساده (انتخاب مدل مناسب و استفاده از حافظه نهان)، هزینه می تواند به طور محسوس تغییر کند. Anthropic در مستنداتش مثال دیگری هم دارد: پردازش ۱۰ هزار تیکت پشتیبانی با میانگین حدود ۳۷۰۰ توکن در هر گفتگو با Haiku 4.5، حدود ۳۷ دلار هزینه دارد [منبع: Anthropic، Pricing].
تخفیف پردازش دسته ای (Batch)
برای کارهای غیرفوری (مثلاً دسته بندی هزاران پیام قدیمی)، سازنده ها گاهی پردازش دسته ای را با نصف قیمت ارائه می دهند. برای Anthropic، این تخفیف ۵۰ درصد برای ورودی و خروجی است [منبع: Anthropic، Pricing]. این روش برای پاسخ زنده به مشتری مناسب نیست، اما برای تحلیل مکالمه ها عالی است.
پارامتر در مدل زبانی بزرگ یعنی چه؟
عبارت «پارامتر» در دنیای مدل های زبانی دو معنای کاملاً متفاوت دارد و اغلب گیج کننده است.
معنی اول: پارامترهای درونی مدل (اندازه مدل)
وقتی می گویند «این مدل هفتاد میلیارد پارامتر دارد»، منظور وزن های ریاضی داخل مدل است؛ مدل این وزن ها را در آموزش می آموزد. مدل با پارامترهای بیشتر معمولاً ظرفیت بیشتری برای یادگیری الگوهای پیچیده دارد، اما اجرا و نگهداری اش هم سنگین تر و گران تر است. کاربر معمولی مقدار پارامترهای درونی را تنظیم نمی کند؛ فقط اندازه مدل را هنگام انتخاب می بیند. البته باید بدانید که تعداد پارامتر به تنهایی معیار کیفیت نیست؛ نحوه آموزش و داده ها هم نقش بزرگی دارند.
معنی دوم: پارامترهای تنظیم پاسخ
این ها تنظیماتی اند که هنگام درخواست از مدل، خودتان تعیین می کنید. مهم ترین هایشان:
دما و انتخاب توکن
دما (Temperature). میزان «خلاقیت» یا تصادفی بودن پاسخ. دمای پایین (نزدیک صفر)، پاسخ های قابل پیش بینی تر و ثابت تر می دهد و برای پشتیبانی مشتری که دقت مهم است مناسب است. دمای بالا پاسخ های متنوع تر می دهد و برای نوشتن خلاقانه بهتر است.
انتخاب از محتمل ترین ها (Top-p و Top-k). این دو هم مثل دما، انتخاب توکن بعدی را کنترل می کنند. Top-p فقط از میان محتمل ترین توکن هایی که مجموع احتمالشان به یک آستانه می رسد انتخاب می کند و Top-k فقط از میان k توکن محتمل تر. معمولاً لازم نیست هر سه را هم زمان تغییر دهید.
سقف پاسخ و توقف
حداکثر توکن خروجی (Max Tokens). سقف طول پاسخ. هم هزینه را مهار می کند و هم از پاسخ های بی پایان جلوگیری می کند.
توالی های توقف (Stop Sequences). رشته هایی که اگر ظاهر شوند، مدل نوشتن را متوقف می کند.
جریمه تکرار و حضور (Frequency و Presence Penalty). جلوی تکرار بیش ازحد کلمات را می گیرند. در بعضی سرویس ها موجودند.
پیام سیستمی و میزان استدلال
پیام سیستمی (System Prompt). دستورالعملی ثابت که نقش، لحن، قوانین و محدودیت های مدل را مشخص می کند. در یک ایجنت پشتیبانی، همین جا تعیین می کنید مدل چطور صحبت کند و چه موقع به انسان ارجاع دهد.
میزان استدلال (Reasoning یا Thinking Effort). در مدل های جدید، می توان تعیین کرد مدل قبل از جواب چقدر «فکر» کند. استدلال بیشتر معمولاً کیفیت پاسخ مسائل پیچیده را افزایش می دهد، اما سرعت را پایین می آورد و هزینه را زیاد می کند. مثلاً در مستندات رسمی Claude، مدل های جدید از «تفکر تطبیقی» استفاده می کنند و میزان تلاش با پارامتری به نام effort قابل تنظیم است [منبع: Anthropic، Models Overview].
یک نکته مهم: همه پارامترها در همه مدل ها و سرویس ها در دسترس نیستند و گاهی سازنده ها بعضی تنظیمات را در مدل های جدید محدود یا حذف می کنند. همیشه مستندات رسمی همان مدل را بخوانید.
مفاهیم مهم دیگر درباره مدل زبانی بزرگ
تاخیر (Latency). زمانی که طول می کشد تا مدل پاسخ دهد. در پشتیبانی مشتری مهم است؛ مدل های کوچک تر معمولاً سریع ترند.
محدودیت نرخ (Rate Limit). سقف تعداد درخواست یا توکن در دقیقه. وقتی حجم پیام بالا می رود، این محدودیت اهمیت پیدا می کند.
تاریخ قطع دانش (Knowledge Cutoff). مدل فقط دانش تا یک تاریخ مشخص را دارد و بعد از آن چیزی نمی داند. برای نمونه، مدل های اصلی Claude تا ژوئن ۲۰۲۶ و Haiku 4.5 تا فوریه ۲۰۲۵ دانش قابل اتکا دارند [منبع: Anthropic، Models Overview]. به همین دلیل باید اطلاعات امروز کسب وکارتان را جداگانه به مدل بدهید.
چندوجهی بودن (Multimodal). توانایی فهمیدن چند نوع ورودی، مثل متن و تصویر. همه مدل های فعلی Claude ورودی متن و تصویر را می پذیرند و خروجی متن می دهند [منبع: Anthropic، Models Overview].
استفاده از ابزار (Tool Use). توانایی مدل در فراخوانی یک ابزار یا سیستم بیرونی، مثل بررسی وضعیت سفارش. این همان چیزی است که مدل را از یک چت بات ساده به یک ایجنت هوشمند تبدیل می کند.
بازیابی اطلاعات (RAG) و تنظیم دقیق (Fine-tuning). دو راه برای آموزش مدل درباره کسب وکار شما. RAG دانش را هنگام پاسخ به مدل می دهد و به روزرسانی آن ساده است. تنظیم دقیق، رفتار یا سبک مدل را تغییر می دهد. برای بیشتر کاربردهای پشتیبانی، RAG منطقی تر و ارزان تر است.
پاسخ ساختگی (Hallucination). گاهی مدل با اطمینان چیزی می گوید که درست نیست. برای کم کردن این مشکل، مدل را به منبع معتبر اطلاعات وصل کنید و اجازه بدهید بگوید «نمی دانم».
حریم خصوصی و محل پردازش. پیام مشتری ها معمولاً شامل اطلاعات شخصی است. قبل از انتخاب مدل یا سرویس، بپرسید سرویس داده ها را کجا پردازش می کند و چقدر نگه می دارد.
نگاهی به چند مدل زبانی بزرگ معروف
جدول زیر چند مدل معروف از سازنده های مختلف را کنار هم قرار می دهد. قیمت ها به دلار و به ازای هر میلیون توکن اند. ما آن ها را در اکتبر ۲۰۲۶ از صفحه های رسمی قیمت گذاری برداشتیم و ممکن است هر زمان تغییر کنند؛ پیش از هر تصمیم، صفحه رسمی را بررسی کنید.
| نکته | مدل | سازنده | ورودی | خروجی |
|---|---|---|---|---|
| استدلال سنگین؛ پنجره ۱ میلیون توکن | Claude Fable 5.1 | Anthropic | ۱۰ | ۵۰ |
| کارهای چندمرحله ای؛ پنجره ۱ میلیون توکن | Claude Opus 5.5 | Anthropic | ۴ | ۲۰ |
| تعادل سرعت و کیفیت؛ پنجره ۱ میلیون توکن | Claude Sonnet 5.5 | Anthropic | ۲ | ۱۰ |
| سریع ترین؛ پنجره ۲۰۰ هزار توکن | Claude Haiku 4.5 | Anthropic | ۱ | ۵ |
| قیمت ورودی حافظه شده: ۱ دلار | GPT-6 Astra | OpenAI | ۱۰ | ۵۰ |
| ورودی حافظه شده فقط ۰.۱ دلار | GPT-6.1 Sol | OpenAI | ۲ | ۱۰ |
| مدل کوچک و ارزان | GPT-6 Luna | OpenAI | ۰.۱ | ۰.۵ |
| مناسب پرامپت تا ۲۰۰ هزار توکن | Gemini 3.1 Pro (پیش نمایش) | ۲ | ۱۲ | |
| قیمت معتبر تا پایان ۲۰۲۶ | Gemini 3.8 Flash | ۰.۷۵ | ۳.۷۵ |
[منبع: Anthropic Models Overview و Pricing؛ OpenAI API Pricing؛ Google Gemini API Pricing]
علاوه بر این ها، خانواده ای از مدل های «متن باز» هم وجود دارد (مثل Llama از شرکت Meta، Mistral، Qwen و DeepSeek) که وزن های آن ها در دسترس است و می توان روی سرور خودتان اجرایشان کرد. مزیتشان کنترل بیشتر روی داده و هزینه ثابت تر است؛ در عوض، راه اندازی و نگهداری شان تخصص فنی می خواهد.
چطور برای پشتیبانی مشتری مدل زبانی بزرگ انتخاب کنیم؟
انتخاب مدل یک «بهترین» مطلق ندارد. چند معیار را با هم ببینید:
کیفیت زبان فارسی. مهم ترین معیار برای مخاطب ایرانی. با چند مکالمه واقعی خودتان، چند مدل را مقایسه کنید.
سرعت. مشتری منتظر پاسخ فوری است.
هزینه. با فرمول بالا، هزینه ماهانه را برای حجم واقعی خودتان بسنجید.
اندازه پنجره زمینه. اگر مکالمه ها طولانی یا دانش تان حجیم است، مهم تر می شود.
پشتیبانی از ابزار. اگر می خواهید ایجنت اقدام هم انجام دهد.
ایمنی و رفتار. مدل باید به قوانینی که تعیین می کنید پایبند بماند و در موارد نامطمئن، به انسان ارجاع دهد.
یک راهبرد رایج و هوشمندانه این است که چند مدل را کنار هم به کار ببرید: مدل کوچک و سریع برای سوالات ساده و پرتکرار، و مدل قوی تر برای مکالمه های پیچیده. به این ترتیب هم هزینه کنترل می شود و هم کیفیت.
استفاده از مدل های زبانی به روز در اَسکینو
شاید فکر کنید انتخاب و تنظیم مدل، مسئله فنی سنگینی است. خبر خوب این است که لازم نیست از صفر شروع کنید.
بیشتر ایجنت های هوش مصنوعی بدون کنترل شما حرف می زنند. اَسکینو را خودتان آموزش می دهید، حتی مستقیم از تلگرام، تا دقیقاً مطابق دانش و قوانین کسب وکارتان پاسخ بدهد. و در اَسکینو می توانید از فهرست کاملی از به روزترین مدل های زبانی در کسب وکار خود استفاده کنید.
چرا اَسکینو انتخاب مطمئنی است؟
پاسخ بر پایه دانش شما. مهم ترین نکته ای که در این مقاله دیدیم: مدل به تنهایی از کسب وکار شما خبر ندارد. در اَسکینو دانش و قوانین را خودتان تعریف می کنید.
لحن برند شما. تعیین می کنید چطور صحبت کند.
انتقال به انسان. در موارد حساس یا نامطمئن، مکالمه به یک عضو تیم می رسد.
یک ایجنت در همه کانال ها. تلگرام، اینستاگرام و واتساپ.
راه اندازی ساده و شروع رایگان. بدون نیاز به دانش فنی عمیق می توانید شروع کنید و با مکالمه های واقعی خودتان بسنجید.
اگر می خواهید قدرت مدل های زبانی را بدون درگیری با جزئیات فنی در پشتیبانی مشتری تان ببینید، ایجنت هوش مصنوعی اَسکینو را رایگان شروع کنید.
اشتباهات رایج درباره مدل زبانی بزرگ و توکن ها
انتخاب بزرگ ترین مدل برای همه کارها. برای سوالات ساده، مدل کوچک تر کافی و بسیار ارزان تر است.
هزینه خروجی را جدی بگیرید. پاسخ های طولانی بی دلیل، هزینه را بالا می برند.
کل تاریخچه و کل دانش را در هر پیام نفرستید. بهتر است فقط بخش مرتبط را بفرستید و از حافظه نهان استفاده کنید.
همه چیز را در پنجره زمینه نریزید. پنجره بزرگ، جایگزین پایگاه دانش مرتب نیست.
ندیدن تفاوت زبان فارسی. تعداد توکن و کیفیت پاسخ فارسی را با نمونه های واقعی بسنجید.
تغییر قیمت و مدل را دست کم نگیرید. قیمت ها و مدل ها سریع عوض می شوند؛ سازنده ها مدل های قدیمی را بازنشسته می کنند. به طور مثال، Anthropic برای هر مدل تاریخ بازنشستگی اعلام می کند [منبع: Anthropic، Models Overview].
تکیه بر مدل بدون پایگاه دانش. مدل بدون اطلاعات دقیق شما، حدس می زند.
نداشتن مسیر انتقال به انسان. حتی بهترین مدل هم گاهی نمی داند.
جمع بندی: مدل زبانی بزرگ در کسب و کار
مدل زبانی بزرگ، سیستمی است که با پیش بینی قدم به قدم متن، پاسخ می سازد. توکن واحد شمارش و هزینه آن است؛ توکن ورودی و خروجی قیمت متفاوتی دارند و حافظه نهان می تواند بخش تکراری ورودی را بسیار ارزان کند. پنجره زمینه سقف حجمی است که مدل در هر درخواست می بیند و بزرگ تر بودنش همیشه بهتر نیست. پارامترهایی مثل دما و حداکثر خروجی هم رفتار مدل را کنترل می کنند.
برای کسب وکار شما، مهم ترین چیز مدل «بزرگ تر» نیست؛ ترکیب مدل مناسب، دانش دقیق، قوانین مشخص و مسیر انتقال به انسان است. اگر می خواهید این ترکیب را بدون دردسر فنی تجربه کنید، اَسکینو را رایگان شروع کنید.
سوالات متداول درباره مدل زبانی بزرگ
نرم افزاری که روی حجم عظیمی از متن تمرین می کند تا زبان را بفهمد و متن تولید کند.
کوچک ترین قطعه متنی که مدل با آن کار می کند؛ هزینه و محدودیت ها را هم با همین قطعه می سنجند.
در انگلیسی تقریباً سه چهارم کلمه یا چهار کاراکتر؛ در فارسی معمولاً هر کلمه توکن بیشتری مصرف می کند و باید با ابزار شمارش، متن خودتان را بسنجید.
ورودی همان چیزی است که به مدل می دهید و خروجی همان چیزی که مدل می نویسد. قیمت خروجی معمولاً چند برابر ورودی است.
بخش تکراری ورودی (مثل دستورالعمل و دانش ثابت) که مدل یک بار پردازش می کند و دفعه های بعد با قیمت بسیار کمتر می خواند.
حداکثر حجم متنی که مدل می تواند در یک درخواست ببیند، شامل ورودی و خروجی.
نه؛ هزینه و تاخیر را افزایش می دهد و پژوهش ها نشان می دهند مدل ها اطلاعات وسط متن های بسیار طولانی را ضعیف تر به کار می برند.
مجموع توکن های ورودی ضرب در قیمت ورودی و توکن های خروجی ضرب در قیمت خروجی، تقسیم بر یک میلیون.
دو معنا دارد: وزن های درونی مدل که اندازه آن را مشخص می کنند، و تنظیماتی مثل دما و حداکثر خروجی که هنگام درخواست تعیین می کنید.
میزان تصادفی بودن پاسخ را تنظیم می کند؛ برای پشتیبانی مشتری معمولاً دمای پایین مناسب تر است.
معمولاً نه؛ برای بیشتر کاربردهای پشتیبانی، وصل کردن مدل آماده به پایگاه دانش کسب وکار کافی است.
مطلقاً «بهترین» وجود ندارد؛ کیفیت فارسی، سرعت، هزینه و ایمنی را با مکالمه های واقعی خودتان بسنجید.
بله. راهبرد رایج این است: مدل کوچک برای سوالات ساده و مدل قوی تر برای موارد پیچیده.
بله. اَسکینو یک ایجنت هوش مصنوعی برای پشتیبانی مشتری است که با دانش، قوانین و لحن کسب وکار شما آموزش می بیند و در تلگرام، اینستاگرام و واتساپ پاسخ می دهد؛ و می توانید از فهرست کاملی از به روزترین مدل های زبانی در آن استفاده کنید. شروع آن رایگان است.
منابع
- Anthropic، Models Overview (platform.claude.com/docs/en/about-claude/models/overview)
- Anthropic، Pricing (platform.claude.com/docs/en/about-claude/pricing)
- OpenAI، API Pricing (developers.openai.com/api/docs/pricing)
- Google، Gemini Developer API Pricing (ai.google.dev/gemini-api/docs/pricing)
- Liu، N. F. و همکاران، «Lost in the Middle: How Language Models Use Long Contexts»، Transactions of the Association for Computational Linguistics، ۲۰۲۴
- صفحه رسمی اَسکینو: askino.chat